
데이터베이스 언어
DDL(definition) : Create, alter, drop
DML(manipulation) : select,insert,delete,update
DCL(control) : commit, rollback,grant,revoke
신뢰성과 가용성
신뢰성은 소프트웨어 입장에서 고장나는 빈도, 기간을 뜻하는 개념
가용성은 클라이언트 입장에서 시스템을 얼마나 이용가능한 지를 뜻하는 개념
https://stage-diary.tistory.com/207
RDBMS
정규화(Normalization)
정규화(Normalization)의 기본 목표는 테이블 간에 중복된 데이타를 허용하지 않는다는 것
중복된 데이터를 허용하지 않음으로써 무결성(Integrity)를 유지할 수 있으며, DB의 저장 용량 역시 줄일 수 있음
테이블을 분해하는 정규화 단계가 정의되어 있는데, 여기서 테이블을 어떻게 분해되는지에 따라 정규화 단계가 달라짐
트랜잭션과 LOCK
참고 : https://suhwan.dev/2019/06/09/transaction-isolation-level-and-lock/
트랜잭션 : 데이터베이스의 데이터를 조작하는 작업의 단위(unit of work)
일반적으로 트랜잭션 = ACID 원칙라고 보여진다. 그러나 ACID를 전부 만족하면서 데이터베이스를 운영하기에는 동시성 처리 성능이 많이 떨어질 수 밖에 없다.
따라서 ACID를 어느정도 포기하면서 동시성을 늘리고자 하는 개념에서 트랜잭션의 Isolation Level이 나왔다.
이때 Isolation Level에 따라 각기 다른 성질을 보장해줄 수 있는 이유는 DB의 스냅샷 기능을 통해 DB의 현재 값을 읽는 게 아니라 특정 시점의 값을 읽을 수 있기 때문이다 → Consistent Read
잠금 범위
우선 잠금 범위에 따라 글로벌 락, 데이터베이스, 테이블, 레코드 등으로 나눌 수 있다.
잠금 수준
잠금 수준은 큰 맥락에서 Exclusive Lock(Write Lock)과 Shared Lock(Read Lock)이 있다.
- Exclusive Lock (Write Lock) : Write를 할 때 사용되는 락 방식
- update, insert, select for update 등을 사용할 때 Exclusive Lock 이 걸림
- Shared Lock (Read Lock) : Read를 할 때 사용되는 락 방식
- SELECT FOR SHARE 같은 일부 쿼리에서 걸림 (일반적인 Select는 안걸림)
여러 트랜잭션은 S Lock을 동시에 걸 수 있으며 이 때 W Lock은 걸 수 없다.
만약 W Lock이 걸려있으면, S Lock, W Lock 모두 걸 수 없다.
트랜잭션 (more)
ACID
트랜잭션이 일어나기 위한 데이터베이스의 기본 속성들
Atomic : 원자성 (성공 혹은 실패)
- 예 : 자금 이체는 성공할 수도 실패할 수도 있지만, 중간 단계까지 실행되고 실패하는 일은 없도록 하는 것.
Consistency : 일관성 (바뀌는 데이터의 속성은 일관성을 가진다)
- 예 : 무결성 제약이 모든 계좌는 잔고가 있어야 한다면, 이를 위반하는 트랜잭션은 중단된다.
Isolation : 고립(수행 중에 다른 트랜잭션 영향 안끼침)
- 예 : 은행 관리자는 이체 작업을 하는 도중에 쿼리를 실행하더라도 특정 계좌간 이체하는 양 쪽을 볼 수 없다.
Durability : 지속성 (비뀐 트랜잭션은 영구적으로 유지)
데이터베이스의 트랜잭션 격리 수준
레벨 0 : Read Uncommited로 무신경하다
레벨 1 : Read Commited 커밋된 레코드만 읽음
레벨 2 : Repeatable Read 특정 트랜잭션이 읽는 리코드에 대해서 끝날 때까지 수정/삭제 방지 (Inno DB의 기본 isolation Level)
레벨 3 : Serializable 여러개 레코드 조회할 때 조회 범위는 새로운 레코드 조회,수정,삭제까지 다 막아버림
참고 : https://jupiny.com/2018/11/30/mysql-transaction-isolation-levels/
MYSQL에서 트랜잭션이 데드락걸렸을 때 어떡해야 될까?
- 트랜잭션을 걸 때 테이블 수준의 잠금을 설정한다 (mysql은 행 수준의 잠금이 기본)
- isolation level 낮춘다
- 트랜잭션은 작고 짧게 유지하기
[TIP]
- 일반적으로 교착상태 감지를 하는건 비효율적일 수 있으니, 비활성화 하고 트랜잭션에 Lock Timeout을 걸어둬도 좋을듯
트랜잭션의 Isolation Level
0단계 Uncommited Read
다른 트랜잭션에서 커밋하기 전의 데이터 변화를 읽을 수 있다
- InnoDB의 경우 Commit되지 않아도 우선 실행된 모든 결과를 DB에 적용하기 때문에 Uncommited Read가 가능함
- Dirty Read
1단계 Commited Read
트랜잭션에서 커밋한 후의 데이터 변화를 읽을 수 있다
- 한 트랜잭션에서 Read할 때 마다 Snapshot을 새로 뜬다. 그래서 커밋 후 데이터 결과를 읽을 수 있음
- Unrepeatable Read : 그러나 한 트랜잭션에서 SELECT 결과가 동일하진 않음. SELECT를 두번했을 때 그 사이에 다른 트랜잭션의 Commit으로 데이터 변화가 있으면 결과가 동일하지 않음
- Oracle, MSSQL의 기본 격리 레벨
- SELECT 실행 시 트랜잭션 기준이 아닌 해당 쿼리가 종료될 때까지만 Shared Lock이 발생한다. 따라서 Repeatable보다 데드락 확률을 낮출 수 있음
2단계 Repeatable Read
트랜잭션 내에서는 SELECT 하는 동안 항상 동일한 결과를 얻어온다. InnoDB의 기본 Isolation Level임
- 트랜잭션의 처음 SELECT를 기준으로 스냅샷을 뜨고 그 뒤의 SELECT에는 스냅샷을 뜨지 않기에 일관성을 보장할 수 있음
- 항상 일관되고 동일한 로우를 반환하지만 다른 트랜잭션의 결과를 무시하기 때문에 현재를 반영하지 못하고 과거의 결과를 반환할 가능성이 높다.
- Repeatable Read는 한 트랜잭션에서 SELECT를 실행 시 대상 레코드에 대해 Shared Lock이 발생한다.
- Mysql InnoDB의 기본 격리 레벨
3단계 Serializable
SELECT 쿼리가 전부 SELECT ... FOR SHARE로 자동으로 변경된다. 따라서 Shared Lock이 레코드에 걸리기에 W Lock은 계속 대기할 수 밖에 없다.
- 쉽게 데드락에 걸릴 수 밖에 없다
[참고]
보통 Repeatable Read는 데드락이 걸릴 가능성이 있어 Commited Read로 내려서 데드락 가능성을 낮추라고 한다.
이유는 Repeatable Read는 한 트랜잭션에서 SELECT를 실행 시 대상 레코드에 대해 Shared Lock이 발생한다. 따라서 다른 트랜잭션에서 Write를 시도할 시 데드락이 발생할 가능성이 있다. 반면 Commited Read의 경우, SELECT 실행 시 트랜잭션 기준이 아닌 해당 쿼리가 종료될 때까지만 Shared Lock이 발생한다. 따라서 데드락 확률을 낮출 수 있음
https://jsonobject.tistory.com/427
OLTP vs OLAP
1) OLTP: On-Line Transaction Processing (데이터 갱신위주)
네트워크 상의 여러 이용자가 실시간으로 데이터베이스의 데이터를 갱신하거나 조회하는 등의 단위작업을 처리하는 방식을 말함
- 예 : 은행에서 수많은 입출금 등이 일어날 때, 이것에 대해 어떠한 방식으로 에러없이 처리를 할 것이냐에 관한 것이라고 생각하면 될 것 같다.
2) OLAP: On-Line Analytic Processing (데이터 조회위주)
정보위주의 처리 분석을 의미한다. 의사결정에 활용할 수 있는 정보를 얻을 수 있게 해주는 기술
- 예 : OLTP에서 처리된 트랜잭션 데이터를 분석해 제품 판매추이, 구매성향파악, 재무회계분석 등을 프로세싱하는 것.
키
Primary Key : 테이블 ROW를 구분하며 NULL을 허용하지 않는 Unique한 키
Candidate Key(후보키) : Primary Key가 될 수 있는 다른 키들
Alternate Key(대체키) : Candidate Key에서 Primary Key를 제외한 키
Super Key : 유일성을 만족하지만 최소성을 만족하지 않아도 되는 KEY
- EX) (주민등록번호, 이름), (주민등록번호, 주소)
[참고] https://jhnyang.tistory.com/71
옵티마이저
SQL을 처리할 때 최저 비용의 경로를 생성해주는 DBMS 내부 핵심 엔진
테이블 관계
테이블간의 관계는 1:1, 1:N, N:M 으로 나뉜다.
1:1 관계는 그냥 foreign key를 한 테이블에 둔다.
1:N 관계는 N의 관계에 있는 친구에게 foreign key를 둔다.
N:M 관계는 이 둘을 연결시켜주는 Associate Table을 새로 만들어둔다.
Connection 관리
WAS에서 DB와 Connection을 맺을 때 소모되는 시간이 생각보다 크다.
- 그래서 보통 WAS에서 동시에 처리할 수 있는 요청 횟수(쓰레드)를 설정한 후 쓰레드 갯수 혹은 그 이하로 Connection Pool의 Idle Size를 관리한다 (initialSize와 maxActive, maxIdle, minIdle 를 똑같이 가져가도 무방하다.)
- 이때 데이터베이스의 Connection limit도 설정해줘야 한다.
인덱스
https://jojoldu.tistory.com/243
0. 인덱스 종류
Clustered Index : 테이블 레코드와 인덱스 칼럼의 정렬 순서가 같은 것. (Primary Index와 유사함)
- 보통 Primary key, Unique Not Null 지정한 열(후보 키)에 Clustered Index가 생성된다)
- 기본적으로 인덱스 칼럼 기준으로 레코드들이 오름차순 정렬됨
- 테이블 당 하나만 생성 가능
- 생성 시 데이터 페이지 전체 재정렬되서 느림
Secondary Index : Clustered Index와 다르게 레코드와 인덱스 칼럼의 순서가 다름
- 어차피 칼럼 값마다 포인터를 가지고 동작하므로 테이블 당 여러개 생성 가능
- 클러스터 인덱스보다는 느리나 CUD에는 덜 느림
1. 해시 인덱스와 B+Tree 인덱스
해시 테이블이 알고리즘 탐색속도 가장 빠름 (O(1)). 그러나 언제까지나 = 일 때 성능이 좋지 <, > 같은 비교 연산자에서는 퍼포먼스가 떨어짐
밸런스 트리(이하 B Tree)는 밸런스를 항상 유지해서 탐색시간은 O(logN)을 가져감. 탐색에 효율적임
B Tree가 가장 Index에서 대중적으로 많이 사용됨
https://helloinyong.tistory.com/296
2. 인덱스하면 좋은 것
- update 빈번하지 않은 것
- 카디널리티(중복 정도의 반대)가 높을 수록 좋음
- 하나의 키값에 여러개의 row가 맵핑이 되는 경우에는 SELECT시 인덱스를 안타고 Full-Scan을 타는 경우가 있을수가 있다. 옵티마이저의 엑세스 방식, 조인 순서를 결정을 하게 된다.
- 조건절에 자주 사용하는 컬럼
- Join시 자주 사용한 컬럼 넣기
3. 스캔 방법
Range Scan
- 범위 대로 잘 찾아서 가는 것
Full Scan
- 조회 조건의 인덱스가 없는 경우 & 변조한 경우 등 모든 데이터를 읽어나가는 방식
Skip Scan
- 조회 조건이 인덱스의 첫 컬럼이 아니거나 첫 컬럼의 종류가 매우 적을 경우
4. 멀티 인덱스
- 카디널리티가 높은 곳에서 낮아지는 방향으로 짤 것
5. 인덱싱 잘하기
- Where 절에서 컬럼을 변경하지 말 것.
- 데이터 타입을 혼동해서 사용하지 말 것
- Null은 인덱스에 걸리지 않는다. 그래서 Full Scan을 하게 됨
- 부정형 조건 또한 인덱스에 걸리지 않음
6. order by와 group by
기본적으로 멀티 컬럼 인덱스에서는 넣어둔 컬럼 순서에 맞게 컬럼을 적어줘야 인덱스가 적용이 됨.
where와 order by나 group by를 같이 써도 인덱싱이 적용될 수 있다. 이때 where 절에서는 = 동등비교문만 가능하고 order by는 안됨.
https://jojoldu.tistory.com/481?category=761883
7. JOIN에 사용되는 INDEX
조인 쿼리에서 각 테이블들의 연결고리가 되는 컬럼들이 인덱스가 걸려있다면 더 빠르게 조인이 가능함.
드라이빙, 드리븐이 있다는 데 난 잘 모르겟다
Join
조인하는 방식은 다양하다.
Nested Loop Join, Sort Merge Join, Hash Join이 있음.
Nested Loop Join
- 좁은 범위에서 유리한 성능 보여줌
- 후행 테이블은 조인을 위한 인덱스 생성 필요
Bigquery가 기존 RDB와 다른점
Bigquery는 쿼리를 할 때 분산 컴퓨팅 기술(MPP)을 사용해 빠른 성능을 보장함
쿼리 성능 측정하는 쿼리
Mysql
[참고]
char vs varchar
char는 고정 길이 문자열 정보를 담는 반면 varchar는 길이가 다양한 컬럼, 정의된 길이와 실제 길이가 차이가 나는 컬럼에 적합함
Datetime 과 Timestamp의 차이
같은 시간이지만 TImestamp는 TimeZone에 영향을 받음. 즉 가변적임
또한 DateTime은 1000-01-01 00:00:00부터 9999-12-31 23:59:59까지 지원하는 반면 Timestamp는 1970-01-01 00:00:01부터 2038-01-19 03:14:07까지 지원해준다
성능 측정하는 쿼리
EXPLAIN : 옵티마이저의 플랜을 알고 싶을 때 사용하는 명령어
Join 방식
mysql은 nested loop join만 지원한다
대량 INSERT를 하려면 어떡해야할까?
https://tomining.tistory.com/197
- One Transaction 처리하기
- Insert Select
- Bulk Insert
참고 : https://prosaist0131.tistory.com/entry/insert와-bulk-insert-무엇을-써야할까요
성능 개선 프로파일링
- 슬로우 쿼리 로그 켜기
- 병목지점 찾기
- 버퍼 크기 조정
MYSQL RECURSIVE
VIEW는 메모리상에 올라가는 가상 테이블이라고 보면 됨. WITH AS도 일종의 VIEW를 만든느 것임. RECURSIVE도 VIEW를 만드는 과정인데 반복적인 수행을 통해 VIEW를 만드는 친구임.
#h 컬럼에 0 ~ 23까지 값을 가지는 뷰를 만든다
WITH RECURSIVE VIEW이름 AS (
	SELECT 0 AS h
	UNION ALL
	SELECT h+1 FROM VIEW이름 WHERE h < 24
)
MYSQL SET 변수
https://programmers.co.kr/learn/courses/30/lessons/59413
mysql 에서 변수를 선언할 때 SET = @변수이름 을 사용함
그리고 변수를 다음과 같이 변경시키면 → @변수이름 := @변수이름 + 1
이를 포함하는 SELECT 문을 전체 실행하게 된다.
SET @hour = 0

SELECT (@hour := @hour + 1) as hour,
(SELECT count(1) FROM ANIMAL_OUTS WHERE HOUR(DATE_TIME)=@hour) as COUNT
FROM ANIMAL_OUTS
WHERE @hour < 23
무결성 & 정합성
무결성 : 데이터 값이 정확하고 완전해야 함을 뜻한다
정합성 : 데이터들 간의 값이 일치해야 함. 같은 데이터를 여러 군데 이동시키거나 변형하는 과정에서 데이터간의 정합성(일치성)이 떨어질 수 있다. 실제로 Segment같은 툴들 사용하는 것도 데이터 정합성이 깨지는 경우가 종종 생겼고, 자체 파이프라인 구축하려고 하는 케이스들이 생김.
NoSQL이란
분산 데이터 처리에서 중요한 건 확장성과 데이터의 유연성임. 일반적으로 객체 스토리지가 많이 사용됨.
NOSQL은 기본적으로 SchemaLess하며 확장성과 Read, Write 성능을 높이는데 초점을 맞춘 데이터베이스
[참고]
NOSQL은 전부 스키마가 없기 보단 레코드가 Schema에 강하게 종속되어있지 않다고 보는 게 정확할 듯. Cassandra같은 경우 스키마가 존재함(물론 레코드 별로 다른 컬럼을 가질 수 있음)
NOSQL 종류
NoSQL은 기본적으로 key-value구조를 차용한다. value의 형식에 따라 크게 key-value, Column Family Oriented, document 등으로 나눌 수 있음.
key-value는 정말 심플하게 key, value 형태로 빠르고 분산처리가 쉬움. 대표적으로 dynamodb가 있음. 그러나 집계기능이 거의 없고 고도의 트랜잭션을 지원해주지 않음
Column Family Oriented 는 단순한 key-value 구조를 극복한 형태임. value별로 다른 column의 데이터를 넣을 수 있는 등 유연성이 높음. 대표적으로 cassandra가 있으며 P2P 방식의 클러스터링임
document 는 스키마가 없고 객체 구조의 데이터를 자유롭게 넣을 수 있다. key-value구조에서 value가 document(json,xml같은)이다. 유연하다고 볼 수 있음. 대표적으로 mongodb가 있음.
search-engine 의 핵심은 역 인덱스. 즉 텍스트를 묶어서 Full-Index를 방지는데 큰 효과있음. 장기적으로 데이터 저장하고 쓰기에는 비싼 편이라 잠시 저장해놓고 Ad-hoc 분석을 하는 ELK 스택으로도 사용되는 편임. elastic search가 대표적인데 document 스토어로 쓸 정도로 데이터 집계도 용이하고 쿼리 엔진도 빵빵하다고 함.
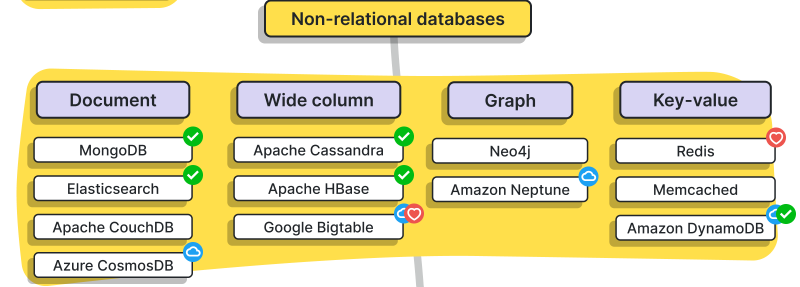
각 Nosql 사용 시 적합한 상황 비교 : https://jaemunbro.medium.com/nosql-%EB%8D%B0%EC%9D%B4%ED%84%B0%EB%B2%A0%EC%9D%B4%EC%8A%A4-%ED%8A%B9%EC%84%B1-%EB%B9%84%EA%B5%90-c9abe1b2838c
Elastic Search
- RESTFUL API 를 제공함
- Schemaless(확장성 굿)하며 분산처리 가능함
- 여러 익스텐션(Kibana, Logstash) 붙여서 안정적인 데이터 수집&분석환경 구축 가능
- 형태소 분석 플러그인이 다양해서 자연어 처리도 쉽게 가능(노리 사용했었음)
- Full Text Search(전문 검색)에 강력함. 비정형 데이터의 색인과 검색이 가능함.
- mysql도 full text search를 제공해주지만 성능 부족.
- 역 색인을 지원해 빠른 검색 & 전문 검색이 가능함
MongoDB
락은 기본적으로 잠금 수준 과 잠금 모드 로 나뉜다.
WiredTiger Lock
- Document Level의 락을 제공해주며 global, database, collection 수준의 Lock도 제공해줌
- 동시성 관리할 때 인 메모리에 스냅샷 형태로 데이터를 관리하다가 Disk에 쓰는 것으로 알고 있음.
- Optimistic Lock을 사용함
- 참고 : https://rastalion.me/mongodb-lock-잠금/
리플리케이션 + 샤딩 같이 쓰면?
샤딩 된 클러스터 안에서 레플리케이션이 일어남
CAP 이론
참고 : https://needjarvis.tistory.com/425
베스트 → https://blog.embian.com/6
분산형 구조는 크게 Consistency, Availability, Partition Tolerance 3가지 특징(CAP)을 가진다.
이 중 셋을 모두 만족하는 건 불가능해서 최대 2가지만 만족할 수 있다고 한다.
Consistency : 어떤 분산 노드로 접근해도 동일한 결과가 나와야 한다
Availability : 한 노드가 망가져도 다른 노드에서 정상적으로 요청을 처리할 수 있는가
Partition Tolerance : 노드간의 통신이 끊겨도 계속 동작할 수 있는가
일반적으로 RDBMS는 CA임. 이유는 Replication을 보통 많이 채택하며, Replication은 Slave가 Master에게 의존을 하게된다. Master가 중단되어도 Slave가 Master로 승진해서 계속 작업하므로 Availability를 채운다. 그러나 마스터와의 통신이 끊겼을 때 동작을 멈춘다 (Consistency를 보장하기 위해)
- 하지만 CAP 이론상 P를 뺀 CA는 의미가 없다고 함. 분산처리의 핵심과는 거리가 있다고 함.
반면 NOSQL은 AP 혹은 CP를 채택한다. 우선 P가 공통적으로 겹치는 이유는 CAP의 기본 이념은 '절대 장애가 없는 네트워크는 없다'는 것이며 따라서 노드 간의 네트워크 장애가 생길 것을 고려했기 때문이다.
P가 유지되려면 C 혹은 A둘 중 하나는 희생되어야 한다. 만약 Availabiliy를 지킨다는 것은 Consistency를 희생하는 것이며, Consistency를 지킨다면 데이터가 동기화될 때까지 동작을 하지 않으므로 Availability는 희생될 것임.
AP 시스템 : 주로 업데이트가 많고 데이터 동기화가 중요하지 않는 SNS에 적합하다. 거래 같이 일관성이 중요한 시스템에는 적합하지 않음 (Cassandra).
- 대신 P2P를 통해 느슨한 일관성은 유지한다고 함 (늦어도 데이터 2초 안에 동기화시킨다고 함
CP 시스템 : Partition장애가 났을 때 Write를 막아서 Consistency를 유지한다. 대신 Availability가 보장되지는 않는다.
애초에 CAP Theorem이 의도했던바는 명확하다. 절대로 장애가 없는 네트워크는 존재하지 않으며, 따라서 분산시스템에서 P는 무조건 인정하고 들어가야 한다는 것이다. 따라서 네트워크가 단절되었을 때 시스템이 어떻게 동작할지 결정해야 하며, 이 때 C와 A를 모두 만족시키는건 불가능하므로 둘 중에 하나를 골라야 한다
Clustering & Replication & Sharding
(클러스터링 개념은 넓은 의미로 복수의 노드를 묶어서 이야기 함)
데이터베이스는 데이터베이스 서버와 데이터 저장소로 나뉜다.
클러스터링은 SPOF를 줄이기 위해 분산환경을 만들고 동기식으로 데이터를 동기화한다. 또한 자동 Fail Over나 Active-standby 등의 기능을 가지고 있다. 다만 데이터를 동기적으로 처리해야 하다 보니 속도가 느리다.
레플리케이션은 보통 Master-Slave 구조를 차용하며 Write, Read 트래픽을 분산시킬 수 있다. 데이터 동기화는 비동기식으로 처리되며, 데이터간 신뢰성을 보장할 수 없다. 클러스터링처럼 자동 Fail Over나 active-standby 기능 등이 따로 없다.
샤딩은 데이터 레코드 기준으로 쪼개서 나누는 파티셔닝 기술임.
파티셔닝
파티셔닝은 크게 Row와 Column 기반으로 나눌 수 있다.
Column 파티셔닝은 OLAP 구조에서 자주 사용된다(특정 컬럼만 사용하는 경우)
Row 파티셔닝은 우리들이 흔히 아는 Sharding이라고도 한다. 여기서 파티션 키는 파티셔닝을 할 때 기준이 되는 키이다.
- Range 파티셔닝 : Timestamp같은 파티션 키를 특정 Range를 기준으로 파티셔닝하는 기술. 분산에는 약할 수 있으나(Hot Partition) range scan에는 뛰어남
- List 파티셔닝 : 파티션 키가 고정 값일 때 사용하는 파티셔닝 기술
- Hash 파티셔닝 : 파티션 키를 hash mod를 통해서 분산시킨다. 데이터 분산은 좋으나 range scan에 취약
SELECT FOR UPDATE
일반적으로 데이터베이스에서 동시성 처리를 할 때 SELECT, UDPATE를 따로 수행하다 보면 Crtical Section이 생길 수 있다. 따라서 SELECT FOR UPDATE 구문을 통해 처음부터 특정 레코드에 대해 LOCK을 걸어버리는 방법이다.
DDL(definition) : Create, alter, drop
DML(manipulation) : select,insert,delete,update
DCL(control) : commit, rollback,grant,revoke