
# 자료구조 : 데이터를 어떠한 형태로 저장하고 관리할 것인지에 대한 방법. 그래서 자료구조는 어떻게 효율적으로 자료를 저장할 것인가에 대한 고민이 필요하다.
# 알고리즘 : 저장된 데이터를 찾거나 변형하거나 수정할 때 필요한 방법.
배열
가장 기본적인 자료구조인 배열은 논리적 저장 순서와 물리적 저장 순서가 일치한다. 따라서, 인덱스(index)로 해당 원소에 접근할 수 있다. 그렇기 때문에 찾고자 하는 원소의 인덱스 값을 알고 있으면 BIG-O(1)에 해당 원소로 접근할 수 있다. random access가 가능하다는 장점이 있다.
하지만 삭제 또는 삽입의 과정에서는 해당 원소에 접근해 작업을 완료한 뒤, 작업을 추가적으로 해줘야 하기 때문에 시간이 더 걸린다. 만약 배열의 원소 중 어느 원소를 삭제했을때 배열의 연속적인 특징이 깨지게 된다.(빈자리가 발생). 따라서 삭제한 원소보다는 큰 인덱스를 갖는 원소들을 shift해줘야 하는데, 이 경우 시간 복잡도가 O(n)이 된다. 그렇기 대문에 Array 자료구조에서 삭제 기능에 대한 시간 복잡도의 worst case는 O(n)이 된다.
- 파이썬에서는 리스트로 배열 구현 가능
# 1차원 배열: 리스트로 구현시
data_list = [1, 2, 3, 4, 5]
data_list
[1, 2, 3, 4, 5]


# 2차원 배열: 리스트로 구현시
data_list = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
data_list
[[1, 2, 3], [4, 5, 6], [7, 8, 9]]
링크드 리스트
위 배열의 단점을 해결하기 위한 자료구조가 Linked List이다. 각각의 원소들은 자지 자신 다음에 어떤 원소인지만을 기억하고 있다. 따라서 이 부분만 다른 값으로 바꿔주면 삭제와 삽입을 O(1)만에 해결할 수 있는 것이다.
하지만, 원하는 위치에 삽입을 하고자 하면 탐색 과정에 있어서 첫번째 원소부터 모두 확인해봐야 한다는 것이다. Array와는 달리 논리적 저장 순서와 물리적 저장 순서가 일치하지 않기 때문이다. 이과정 때문에, 어떠한 원소를 삭제 또는 추가하고자 했을때, 그 원소를 찾기 위해서 O(n)의 시간이 추가적으로 발생하게 된다.
결국 Linked List 자료구조는 탐색에 O(n)의 시간 복잡도를 갖고 삽입, 삭제에도 같은 시간 복잡도를 갖는다. 그렇다하더라도 연결 리스트는 tree구조의 근간이 되기 때문에 매우 중요한 개념이다.
- 코드 구현
class Node:
    def __init__(self, data):
        self.data = data
        self.next = None

class NodeMgmt:
    def __init__(self, data):
        self.head = Node(data)

    def add(self, data):
        if self.head == '':
            self.head = Node(data)
        else:
            node = self.head
            while node.next:
                node = node.next
            node.next = Node(data)

    def desc(self):
        node = self.head
        while node:
            print (node.data)
            node = node.next

    def delete(self, data):
        if self.head == '':
            print ('해당 값을 가진 노드가 없습니다.')
            return
        if self.head.data == data: # 경우의 수1: self.head를 삭제해야할 경우 - self.head를 바꿔줘야 함
            temp = self.head # self.head 객체를 삭제하기 위해, 임시로 temp에 담아서 객체를 삭제했음
            self.head = self.head.next # 만약 self.head 객체를 삭제하면, 이 코드가 실행이 안되기 때문!
            del temp
        else:
            node = self.head
            while node.next: # 경우의 수2: self.head가 아닌 노드를 삭제해야할 경우
                if node.next.data == data:
                    temp = node.next
                    node.next = node.next.next
                    del temp
                    pass
                else:
                    node = node.next

    def search_node(self, data):
        node = self.head
        while node:
            if node.data == data:
                return node
            else:
                node = node.next
큐
선형 자료구조의 일종으로 First in First Out(FIFO)즉, 먼저 들어간 데이턱라 먼저 호출된다. stack과는 반대로 먼저 들어간 데이터가 맨 앞에서 대기하고 있다가 먼저 나오는 구조이다.
- 코드 구현
import queue

my_queue_list = queue.Queue()

a = [1,2,3,4,5]

my_queue_list.put(a)

my_queue_list.get()
스택
선형 자료구조의 일종으로 Last In First Out(LIFO). 즉, 나중에 들어간 원소가 먼저 나온다. 이것은 stack의 가장 큰 특징이다. 차곡차곡 쌓이는 구조로 먼저 stack에 들어가게 된 원소는 맨 바닥에 깔리게 된다. 그렇기 때문에 늦게 들어간 자료들이 쌓이게 되고 호출 시 가장 위에 있는 자료(나 함수 등등)가 호출되는 구조이다.
- 코드 구현
stack_list = list()

def push(data):
    stack_list.append(data)

def pop():
    data = stack_list[-1]
    del stack_list[-1]
    return data
해쉬 테이블
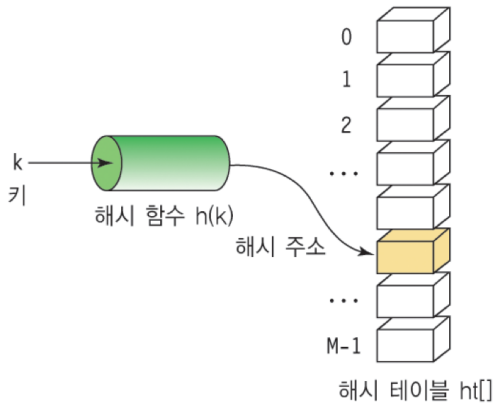
hash는 내부적으로 배열을 사용하여 데이터를 저장하기 때문에 빠른 검색 속도를 갖는다. 특정한 값을 검색하는데 데이터 고유의 인덱스로 접근하게 되므로 average case에 대하여 시간 복잡도가 O(1)이 되는 것이다. 하지만 문제는 이 인덱스로 저장되는 key값이 불규칙하다는 것이다.
그래서 특별한 알고리즘을 이용하여 저장할 데이터와 연관된 고유한 숫자를 만들어 낸 뒤 이를 인덱스로 사용한다. 특정 데이터가 저장되는 인덱스는 그 데이터만의 고유한 위치이기 때문에, 삽입 연산 시 다른 데이터의 사이에 끼어들거나, 삭제 시 다른 데이터로 채울 필요가 없으므로 연산에서 추가되는 비용이 없도록 만들어진 구조이다.
특별한 알고리즘이란 것을 통해 고유한 인덱스 값을 설정하는 것이 중요해보인다. 위에서 언급한 '특별한 알고리즘'을 hash method 또는 해시 함수(hash function)을 통해서 작은 범위의 값들로 바꿔준다.
하지만 어설픈 hash function을 통해서 key값들을 결정한다면 동일한 값이 도출될 수 가 있다. 이렇게 되면 동일한 key 값에 복수 개의 데이터가 하나의 테이블에 존재할 수 있게 되는 것인데 이를 collision이라고 한다.
collision : 서로 다른 두 개의 키가 같은 인덱스로 hashing(hash 함수를 통해 계산됨을 의미)되면 같은 곳에 저장할 수 없게 된다.
좋은 해쉬 함수란?
해쉬 함수를 무조건 1: 1로 만드는 것보단 collision을 최소화하는 방향으로 설계하고 발생하는 collision에 대비해 어떻게 대응할 것인가가 더 중요하다. collision이 많아 질수록 search에 필요한 시간 복잡도가 O(1)에서 O(n)에 가까워진다.
따라서 hashing된 인덱스에 이미 다른 값이 들어 있다면, 세 데이터를 저장할 다른 위치를 찾은 뒤에야 저장할 수 있는 것이다. 따라서 충돌 해결은 필수이다.
- 코드 구현
import hashlib

hash_table = list([0 for i in range(8)])

def get_key(data):
        hash_object = hashlib.sha256()
        hash_object.update(data.encode())
        hex_dig = hash_object.hexdigest()
        return int(hex_dig, 16)

def hash_function(key):
    return key % 8

def save_data(data, value):
    index_key = get_key(data)
    hash_address = hash_function(index_key)
    if hash_table[hash_address] != 0:
        for index in range(hash_address, len(hash_table)):
            if hash_table[index] == 0:
                hash_table[index] = [index_key, value]
                return
            elif hash_table[index][0] == index_key:
                hash_table[index][1] = value
                return
    else:
        hash_table[hash_address] = [index_key, value]

def read_data(data):
    index_key = get_key(data)
    hash_address = hash_function(index_key)

    if hash_table[hash_address] != 0:
        for index in range(hash_address, len(hash_table)):
            if hash_table[index] == 0:
                return None
            elif hash_table[index][0] == index_key:
                return hash_table[index][1]
    else:
        return None
트리
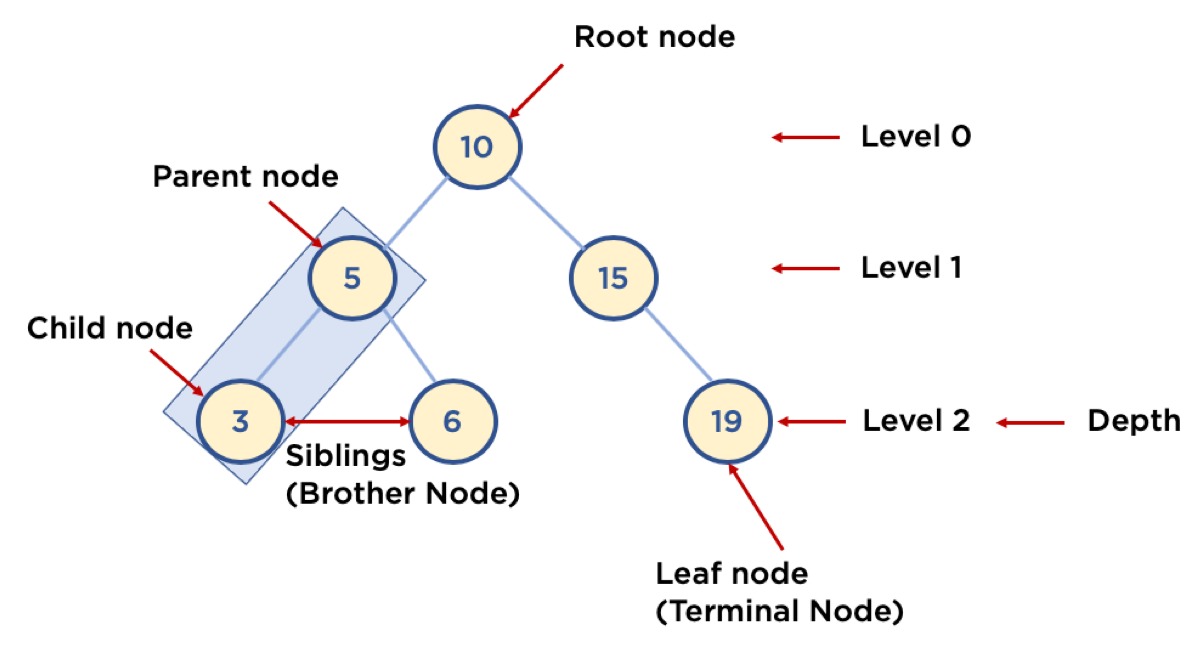
트리는 스택이나 큐와 같은 선형 구조가 아닌 비선형 자료구조이다. 트리는 계층적 관계를 표현하는 자료구조이다.
트리 구성요소(용어)
- Node(노드) : 트리를 구성하고 있는 각각의 요소를 의미한다.
- Edge(간선) : 트리를 구성하기 위해 노드와 노드를 연결하는 선을 의미한다.
- Root node(루트 노드) : 트리 구조에서 최상위에 있는 노드를 의미한다.
- Terminal Node( = leaf Node, 단말노드) : 하위에 다른 노드가 연결되어 있지 않은 노드를 의미한다.
- Internal Node(내부노드, 비단말 노드) : 단말 노드를 제외한 모든 노드로 루트 노드를 포함한다.
- 코드 구현은 너무... 길고 복잡해서 트리 코딩테스트 연습으로 대체한다..